GLM-5.3-BF16
GLM-5.3-BF16
摘要
GLM-5.3 与 GLM-5.2 共享同一基座模型,改进均来自后训练阶段。其在 Z.ai Code Bench 上较 GLM-5.2 提升 50%,并在 Terminal Bench 3.0、Agents' Last Exam 等公开 benchmark 上达到开源 SOTA。模型在 CyberGym 漏洞发现任务上取得 SOTA,利用 benchmark 表现较 GLM-5.2 提升一倍以上。GLM-5.3 支持 SGLang、vLLM、Transformers 等框架部署,并可通过 reasoning_effort 参数控制思考预算。
GLM-5.3-BF16
GLM-5.3 与 GLM-5.2 使用相同的基座模型——所有提升均来自后训练阶段。与 GLM-5.2 相比,它在复杂编码和长周期任务上表现显著更优:
- 更强的编码能力:GLM-5.3 是编码能力最强的开放权重模型,在我们内部的 Z.ai Code Bench 上相比 GLM-5.2 提升了 50%。同时,它在 Terminal Bench 3.0 和 Agents' Last Exam 等公开 benchmark 上也达到了开源 SOTA。
- 涌现的网络攻防能力:随着后训练规模的扩大,网络攻防能力的发展速度超出了我们的预期。GLM-5.3 在 CyberGym 漏洞发现任务上达到 SOTA,且其提升在利用链(exploitation chain)的更深环节最为显著,在利用(exploitation)benchmark 上的表现相比 GLM-5.2 提升了一倍以上。
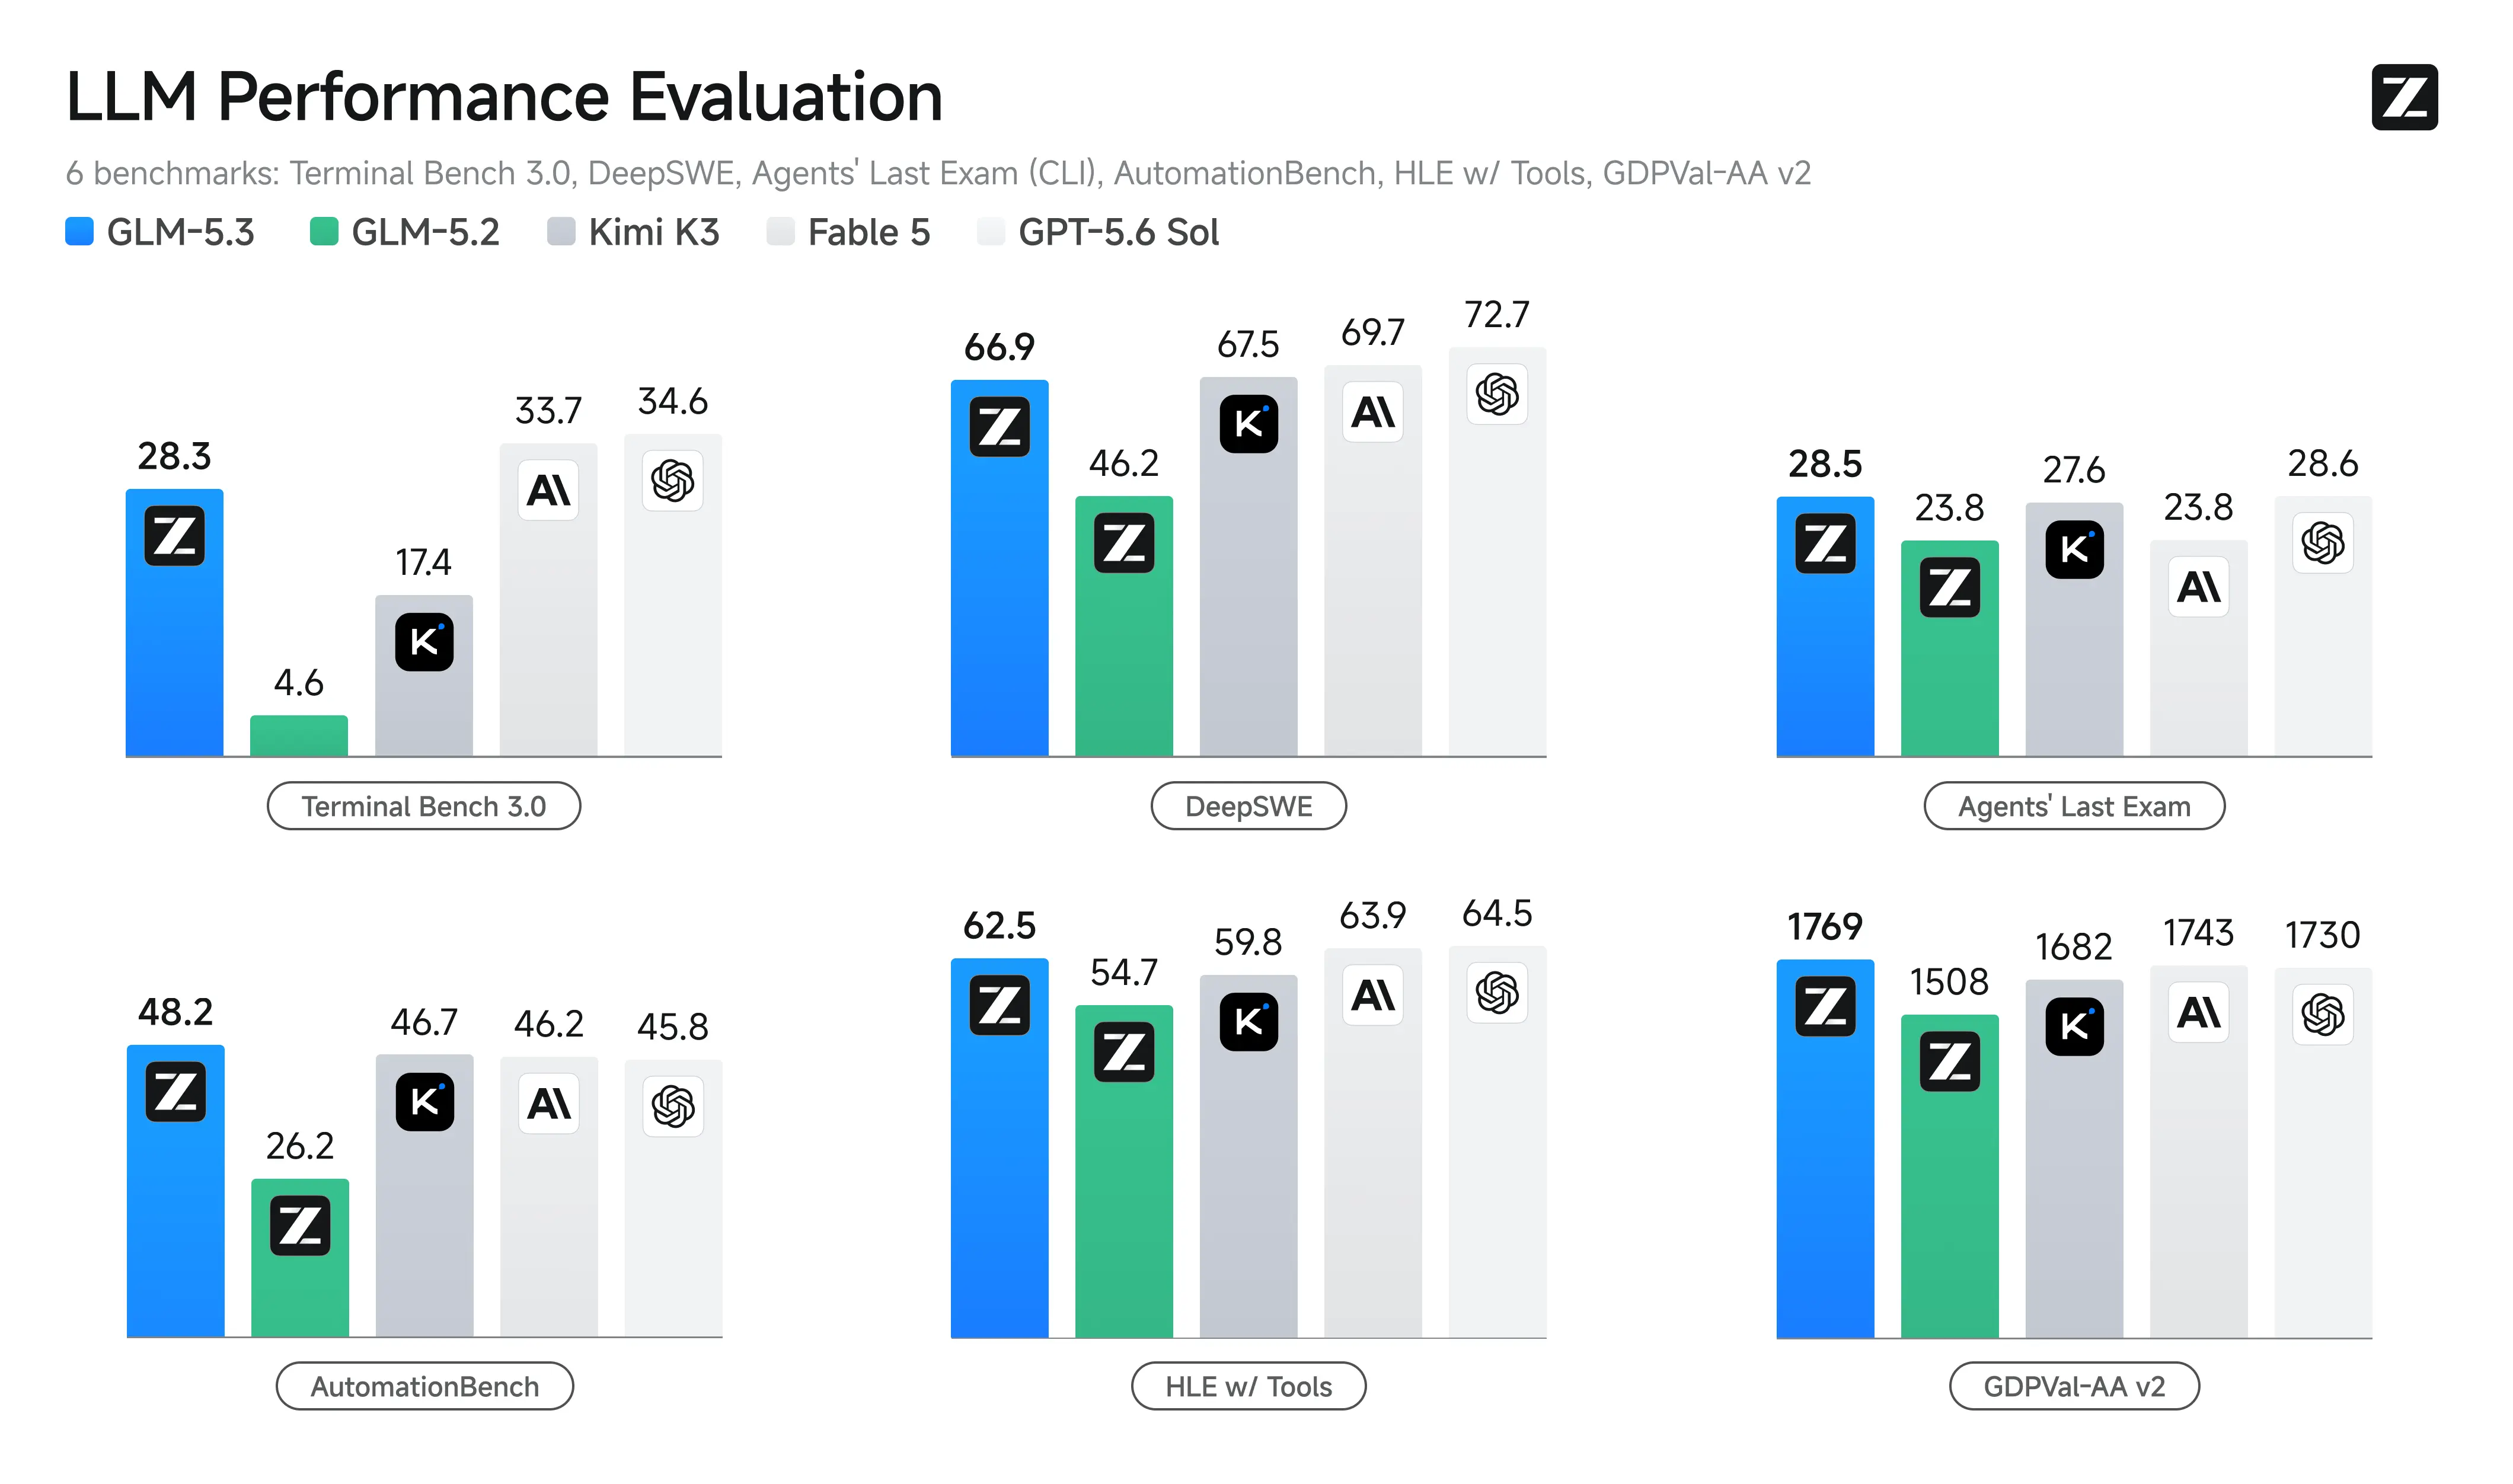
Benchmark
| Benchmark | GLM-5.3 | GLM-5.2 | Kimi K3 | DeepSeek-V4 Pro-0813 | Qwen3.8-Max | Opus 4.8 | Fable 5 (w/ fallback) | GPT-5.6 Sol |
|---|---|---|---|---|---|---|---|---|
| Terminal Bench 2.1 | 88.2 | 81.0 | 88.3 | 87.9 | 86.6 | 85.0 | 88.0 | 88.8 |
| Terminal Bench 3.0 | 28.3 | 4.6 | 17.4 | – | – | 21.1 | 33.7 | 34.6 |
| DeepSWE (v1.1) | 66.9 | 46.2 | 67.5 | 62.7 | 56.6 | 58.0 | 69.7 | 72.7 |
| NL2Repo | 58.0 | 48.9 | 58.0 | 61.1 | 55.9 | 69.7 | – | – |
| ProgramBench (Almost Solved) | 19.0 | 9.5 | 17.5 | – | 10.5 | 15.5 | 33.0 | 23.0 |
| FrontierSWE | 78.1 | 67.5 | – | – | – | 66.5 | 88.2 | – |
| SWE-Marathon (v1.1) | 42.5 | 19.4 | 48.1 | – | – | 48.8 | 33.1 | 42.5 |
| PostTrainBench | 39.8 | 31.7 | 32.0 | – | – | 32.9 | 41.8 | 36.2 |
| CyberGym | 84.5 | 77.2 | 80.0 | 83.3 | 78.5 | 78.1 | 83.8 | 83.6 |
| ExploitGym (2h / 6h) | 105 / 130 | 29 / 39 | 36 / 70 | – | 14 / 26 | 80 / 120 | 181 / 247 | 216 / 293 |
| ExploitBench | 54.4 | 24.4 | 32.2 | – | 28.8 | 40.0 | 78.0 | 76.5 |
| Toolathlon Verified | 73.0 | 59.9 | 76.5 | 74.1 | 72.5 | 76.2 | 74.7 | 74.9 |
| AutomationBench (v1.0.6) | 48.2 | 26.2 | 46.7 | 43.2 | 39.8 | 41.0 | 46.2 | 45.8 |
| Agents' Last Exam (ALE-CLI) | 28.5 | 23.8 | 27.6 | 25.7 | 27.0 | 25.7 | 23.8 | 28.6 |
| HLE w/ Tools | 62.5 | 54.7 | 59.8 | 60.0 | 56.2 | 57.9 | 63.9 | 64.5 |
| GDPval-AA v2 | 1769 | 1508 | 1682 | 1590 | 1739 | 1588 | 1743 | 1730 |
本地部署 GLM-5.3
GLM-5.3 支持通过以下框架进行部署,欢迎尝试:
- SGLang — 参见 cookbook
- vLLM — 参见 recipes
- TokenSpeed — 参见 此处
- Transformers — 参见 transformers 文档
- KTransformers — 参见 教程
- Unsloth — 参见 指南
- 在
Ascend NPU平台上部署时,支持 vLLM-Ascend、xLLM 和 SGLang 等推理框架 — 参见 此处。
注意
- GLM-5.3 支持通过
reasoning_effort参数控制思考预算,该参数接受三个级别:low、high和max。如果未传入(或设置为其他任何值),则默认为max。如需使用low或high,请显式传入。对于 benchmark 和排行榜复现,请保持默认的max。 - 在 GLM-5.3 的 chat template 中,如果未传入
clear_thinking,则默认为false。对于聊天场景,请显式传入clear_thinking=true。
脚注
- HLE w/ tools:我们使用
temperature=1.0和top_p=0.95的采样参数进行评估,最大生成长度为163,840tokens。评估在最大上下文长度为300,000tokens 的条件下进行,并采用上下文管理策略。我们使用 GPT-5.6-luna (medium) 作为评判模型。 - NL2Repo:我们在 1M 上下文下,使用
temperature=1.0、top_p=1.0和max_new_tokens=64k评估了 NL2Repo。为防止作弊,我们使用基于规则和基于 LLM 的判断来阻止恶意行为(例如,未经授权的 pip 或 curl 操作)。 - DeepSWE:我们使用 mini-swe-agent harness 运行 DeepSWE,参数为
temperature=0.95、top_p=1.0、timeout=6h和 400K 上下文。 - Terminal-Bench 2.1:我们在 Claude Code 2.1.207 中评估,参数为
temperature=1.0、top_p=1、max_new_tokens=65536,超时时间为 6 小时。 - Terminal-Bench 3.0:我们使用 Claude Code 2.1.207 harness(reasoning effort=max,400K 上下文,128K 最大输出)评估 Terminal-Bench-3 任务,报告每个任务三次 rollout 的 avg@3。每次 rollout 在基于任务官方镜像构建的隔离容器中运行,上限为 600 个 agent 轮次,超时时间为 10 小时。Tool Search 被禁用,每个 agent 产生的 artifacts 由任务官方的独立验证器评分。
- Agent's Last Exam (CLI):我们使用官方评估协议和 Claude Code harness(reasoning effort=max,1M 上下文,64K 最大输出)评估 ALE。105 个任务中的每一个都在使用其 Task Card 中声明的资源的隔离 Docker 容器中运行。默认超时时间为 4 小时,任务特定限制优先(最长 8 小时)。Tool Search 被禁用,结果由官方 ALE 评估器评分。
- Toolathlon Verified:我们通过官方评估服务获得所有结果,并报告 3 次独立运行的平均 pass@1。
- AutomationBench:我们在 AutomationBench v1.0.6 上进行评估,该版本包含了 PR #13 中引入的
null类型处理问题的修复。 - GDPval-AA v2:模型由 Artificial Analysis 评估。
- CyberGym:我们在 Claude Code 2.1.207 中评估 GLM-5.3(最大推理努力,无 web 工具,
temperature=1.0,top_p=1.0,max_new_tokens=128000)。所有评估均在每个任务无时间限制下进行,结果为 1,507 个任务的单次运行 Pass@1。为模拟真实使用场景,我们将 agent 放置在任务容器内。我们还移除了所有与 Git 相关的信息,并应用域名白名单(仅允许 pypi.org 和 deb.debian.org 等基本工具安装所需域名)以防止 agent 作弊。 - ExploitGym:我们在 Claude Code 2.1.207 中评估 GLM-5.3、Kimi-K3 和 Qwen3.8 Max(最大推理努力,无 web 工具,
temperature=1.0,top_p=1.0,max_new_tokens=128000)。报告的结果是在 869 个任务上、两个超时预算(2 小时和 6 小时)下的单次运行 Pass@1,计算方式为 API 推理时间按每个模型的每秒 tokens 速率(per-model TPS 来自 Artificial Analysis;即,我们将 GLM-5.3 的结果按 115 TPS 重新缩放,Kimi K3 的结果按 40 TPS,Qwen3.8 Max 的结果按 47 TPS)重新缩放,再加上非 API 开销。我们还应用了域名白名单(仅允许 pypi.org 和 deb.debian.org 等基本工具安装所需域名)以防止 agent 作弊。 - ExploitBench:我们在 Claude Code 2.1.207 中评估 GLM-5.3(最大推理努力,无 web 工具,
temperature=1.0,top_p=1.0,max_new_tokens=128000)。遵循官方评估设置,我们将 agent 与环境之间的最大交互轮数限制为 300,并计算所有 41 个任务在 3 个修订版本上的平均覆盖率得分。任务的覆盖率结果通过取所有修订版本中实现能力的并集来确定,平均得分通过对结果取平均获得。我们还应用了域名白名单(仅允许 pypi.org 和 deb.debian.org 等基本工具安装所需域名)以防止 agent 作弊。 - FrontierSWE:该评估由 Proximal 进行,使用 1M 上下文长度、最大努力级别和 128K 最大输出 tokens。报告的 Dominance 得分截至 2026/08/14。
- PostTrainBench:我们使用 Claude Code 2.1.207 评估 GLM-5.3,采用最大努力级别、
temperature = 1.0、top_p = 1.0、max_new_tokens = 128000和 1M-token 上下文窗口。我们报告 3 次运行的加权平均值。未能产生分数的运行将回退到官方的 zero-shot 基座模型基线分数。对于旨在防止使用第三方 API 的检查,我们移除了原始的基于模式匹配的检查,因为当通过 OpenAI SDK 访问本地 vLLM endpoint 时,这些检查会产生误报。取而代之,我们使用 LLM agent 检查解决方案中是否存在外部 API 使用。 - SWE-Marathon:我们使用 Claude Code 2.1.207 评估 GLM-5.3,采用最大努力级别、
temperature = 1.0、top_p = 0.95、max_new_tokens = 128000和 1M-token 上下文窗口。对于strip-clone,原始的防作弊检查使用了过于宽泛的导入检测,可能会拒绝有效的实现。我们移除了受影响的检查,并改用基于 LLM 的检查以避免误报。对于parameter-golf和trimul-cuda,NVIDIA wheels 的更改导致 Docker 镜像构建失败,因此我们添加了--extra-index-url https://pypi.org/simple以恢复成功构建。
引用
如果您在研究中发现 GLM-5.3 有用,请引用我们的技术报告:
@misc{glm5team2026glm5vibecodingagentic,
      title={GLM-5: from Vibe Coding to Agentic Engineering},
      author={GLM-5-Team and : and Aohan Zeng and Xin Lv and Zhenyu Hou and Zhengxiao Du and Qinkai Zheng and Bin Chen and Da Yin and Chendi Ge and Chenghua Huang and Chengxing Xie and Chenzheng Zhu and Congfeng Yin and Cunxiang Wang and Gengzheng Pan and Hao Zeng and Haoke Zhang and Haoran Wang and Huilong Chen and Jiajie Zhang and Jian Jiao and Jiaqi Guo and Jingsen Wang and Jingzhao Du and Jinzhu Wu and Kedong Wang and Lei Li and Lin Fan and Lucen Zhong and Mingdao Liu and Mingming Zhao and Pengfan Du and Qian Dong and Rui Lu and Shuang-Li and Shulin Cao and Song Liu and Ting Jiang and Xiaodong Chen and Xiaohan Zhang and Xuancheng Huang and Xuezhen Dong and Yabo Xu and Yao Wei and Yifan An and Yilin Niu and Yitong Zhu and Yuanhao Wen and Yukuo Cen and Yushi Bai and Zhongpei Qiao and Zihan Wang and Zikang Wang and Zilin Zhu and Ziqiang Liu and Zixuan Li and Bojie Wang and Bosi Wen and Can Huang and Changpeng Cai and Chao Yu and Chen Li and Chengwei Hu and Chenhui Zhang and Dan Zhang and Daoyan Lin and Dayong Yang and Di Wang and Ding Ai and Erle Zhu and Fangzhou Yi and Feiyu Chen and Guohong Wen and Hailong Sun and Haisha Zhao and Haiyi Hu and Hanchen Zhang and Hanrui Liu and Hanyu Zhang and Hao Peng and Hao Tai and Haobo Zhang and He Liu and Hongwei Wang and Hongxi Yan and Hongyu Ge and Huan Liu and Huanpeng Chu and Jia'ni Zhao and Jiachen Wang and Jiajing Zhao and Jiamin Ren and Jiapeng Wang and Jiaxin Zhang and Jiayi Gui and Jiayue Zhao and Jijie Li and Jing An and Jing Li and Jingwei Yuan and Jinhua Du and Jinxin Liu and Junkai Zhi and Junwen Duan and Kaiyue Zhou and Kangjian Wei and Ke Wang and Keyun Luo and Laiqiang Zhang and Leigang Sha and Liang Xu and Lindong Wu and Lintao Ding and Lu Chen and Minghao Li and Nianyi Lin and Pan Ta and Qiang Zou and Rongjun Song and Ruiqi Yang and Shangqing Tu and Shangtong Yang and Shaoxiang Wu and Shengyan Zhang and Shijie Li and Shuang Li and Shuyi Fan and Wei Qin and Wei Tian and Weining Zhang and Wenbo Yu and Wenjie Liang and Xiang Kuang and Xiangmeng Cheng and Xiangyang Li and Xiaoquan Yan and Xiaowei Hu and Xiaoying Ling and Xing Fan and Xingye Xia and Xinyuan Zhang and Xinze Zhang and Xirui Pan and Xu Zou and Xunkai Zhang and Yadi Liu and Yandong Wu and Yanfu Li and Yidong Wang and Yifan Zhu and Yijun Tan and Yilin Zhou and Yiming Pan and Ying Zhang and Yinpei Su and Yipeng Geng and Yong Yan and Yonglin Tan and Yuean Bi and Yuhan Shen and Yuhao Yang and Yujiang Li and Yunan Liu and Yunqing Wang and Yuntao Li and Yurong Wu and Yutao Zhang and Yuxi Duan and Yuxuan Zhang and Zezhen Liu and Zhengtao Jiang and Zhenhe Yan and Zheyu Zhang and Zhixiang Wei and Zhuo Chen and Zhuoer Feng and Zijun Yao and Ziwei Chai and Ziyuan Wang and Zuzhou Zhang and Bin Xu and Minlie Huang and Hongning Wang and Juanzi Li and Yuxiao Dong and Jie Tang},
      year={2026},
      eprint={2602.15763},
      archivePrefix={arXiv},
      primaryClass={cs.LG},
      url={https://arxiv.org/abs/2602.15763},
}
译自 GLM · HF · 智谱 · 录于 二〇二六年九月八日