Qwen3.8-Flash-Next
Qwen3.8-Flash-Next
Qwen团队发布Qwen3.8-Flash-Next,为Qwen4架构的实验性预览,以Hugging Face Transformers格式开源后训练权重。该模型为125B参数(激活6B)的因果语言模型,引入基于QSA的混合注意力、Gated Residual、N-gram Embedding(51B参数)及定制化训练方案,原生支持262,144 token上下文,可扩展至1M。在DeepSWE 1.1(58.7)、SWE-bench Pro(62.5)、GPQA Diamond(91.7)等benchmark上取得领先成绩,兼容vLLM、SGLang、TokenSpeed等框架。
Qwen3.8-Flash-Next
[!Note] 本仓库包含以 Hugging Face Transformers 格式存储的后训练模型权重和配置文件。
这些产物与 Hugging Face Transformers、vLLM、SGLang、TokenSpeed 等兼容。
[!Tip] 对于需要托管式、可扩展推理且无需维护基础设施的用户,官方 Qwen API 服务由 Qwen Cloud 提供。
特别是,Qwen3.8-Flash 是基于 Qwen3.8-Flash-Next 的官方版本,具备更多生产级特性,例如默认 1M 上下文长度、官方内置工具。更多信息请参阅 Qwen3.8-Flash 概览。
随着基础模型的边界不断向更大参数规模和更长上下文窗口推进,问题已不再仅仅是我们能扩展多少,而是我们能以多高的效率进行扩展。朝着惠及所有人的通用人工智能(AGI)的可持续进展需要架构创新。今天,我们分享朝着这一方向迈出的具体一步:Qwen3.8-Flash-Next。
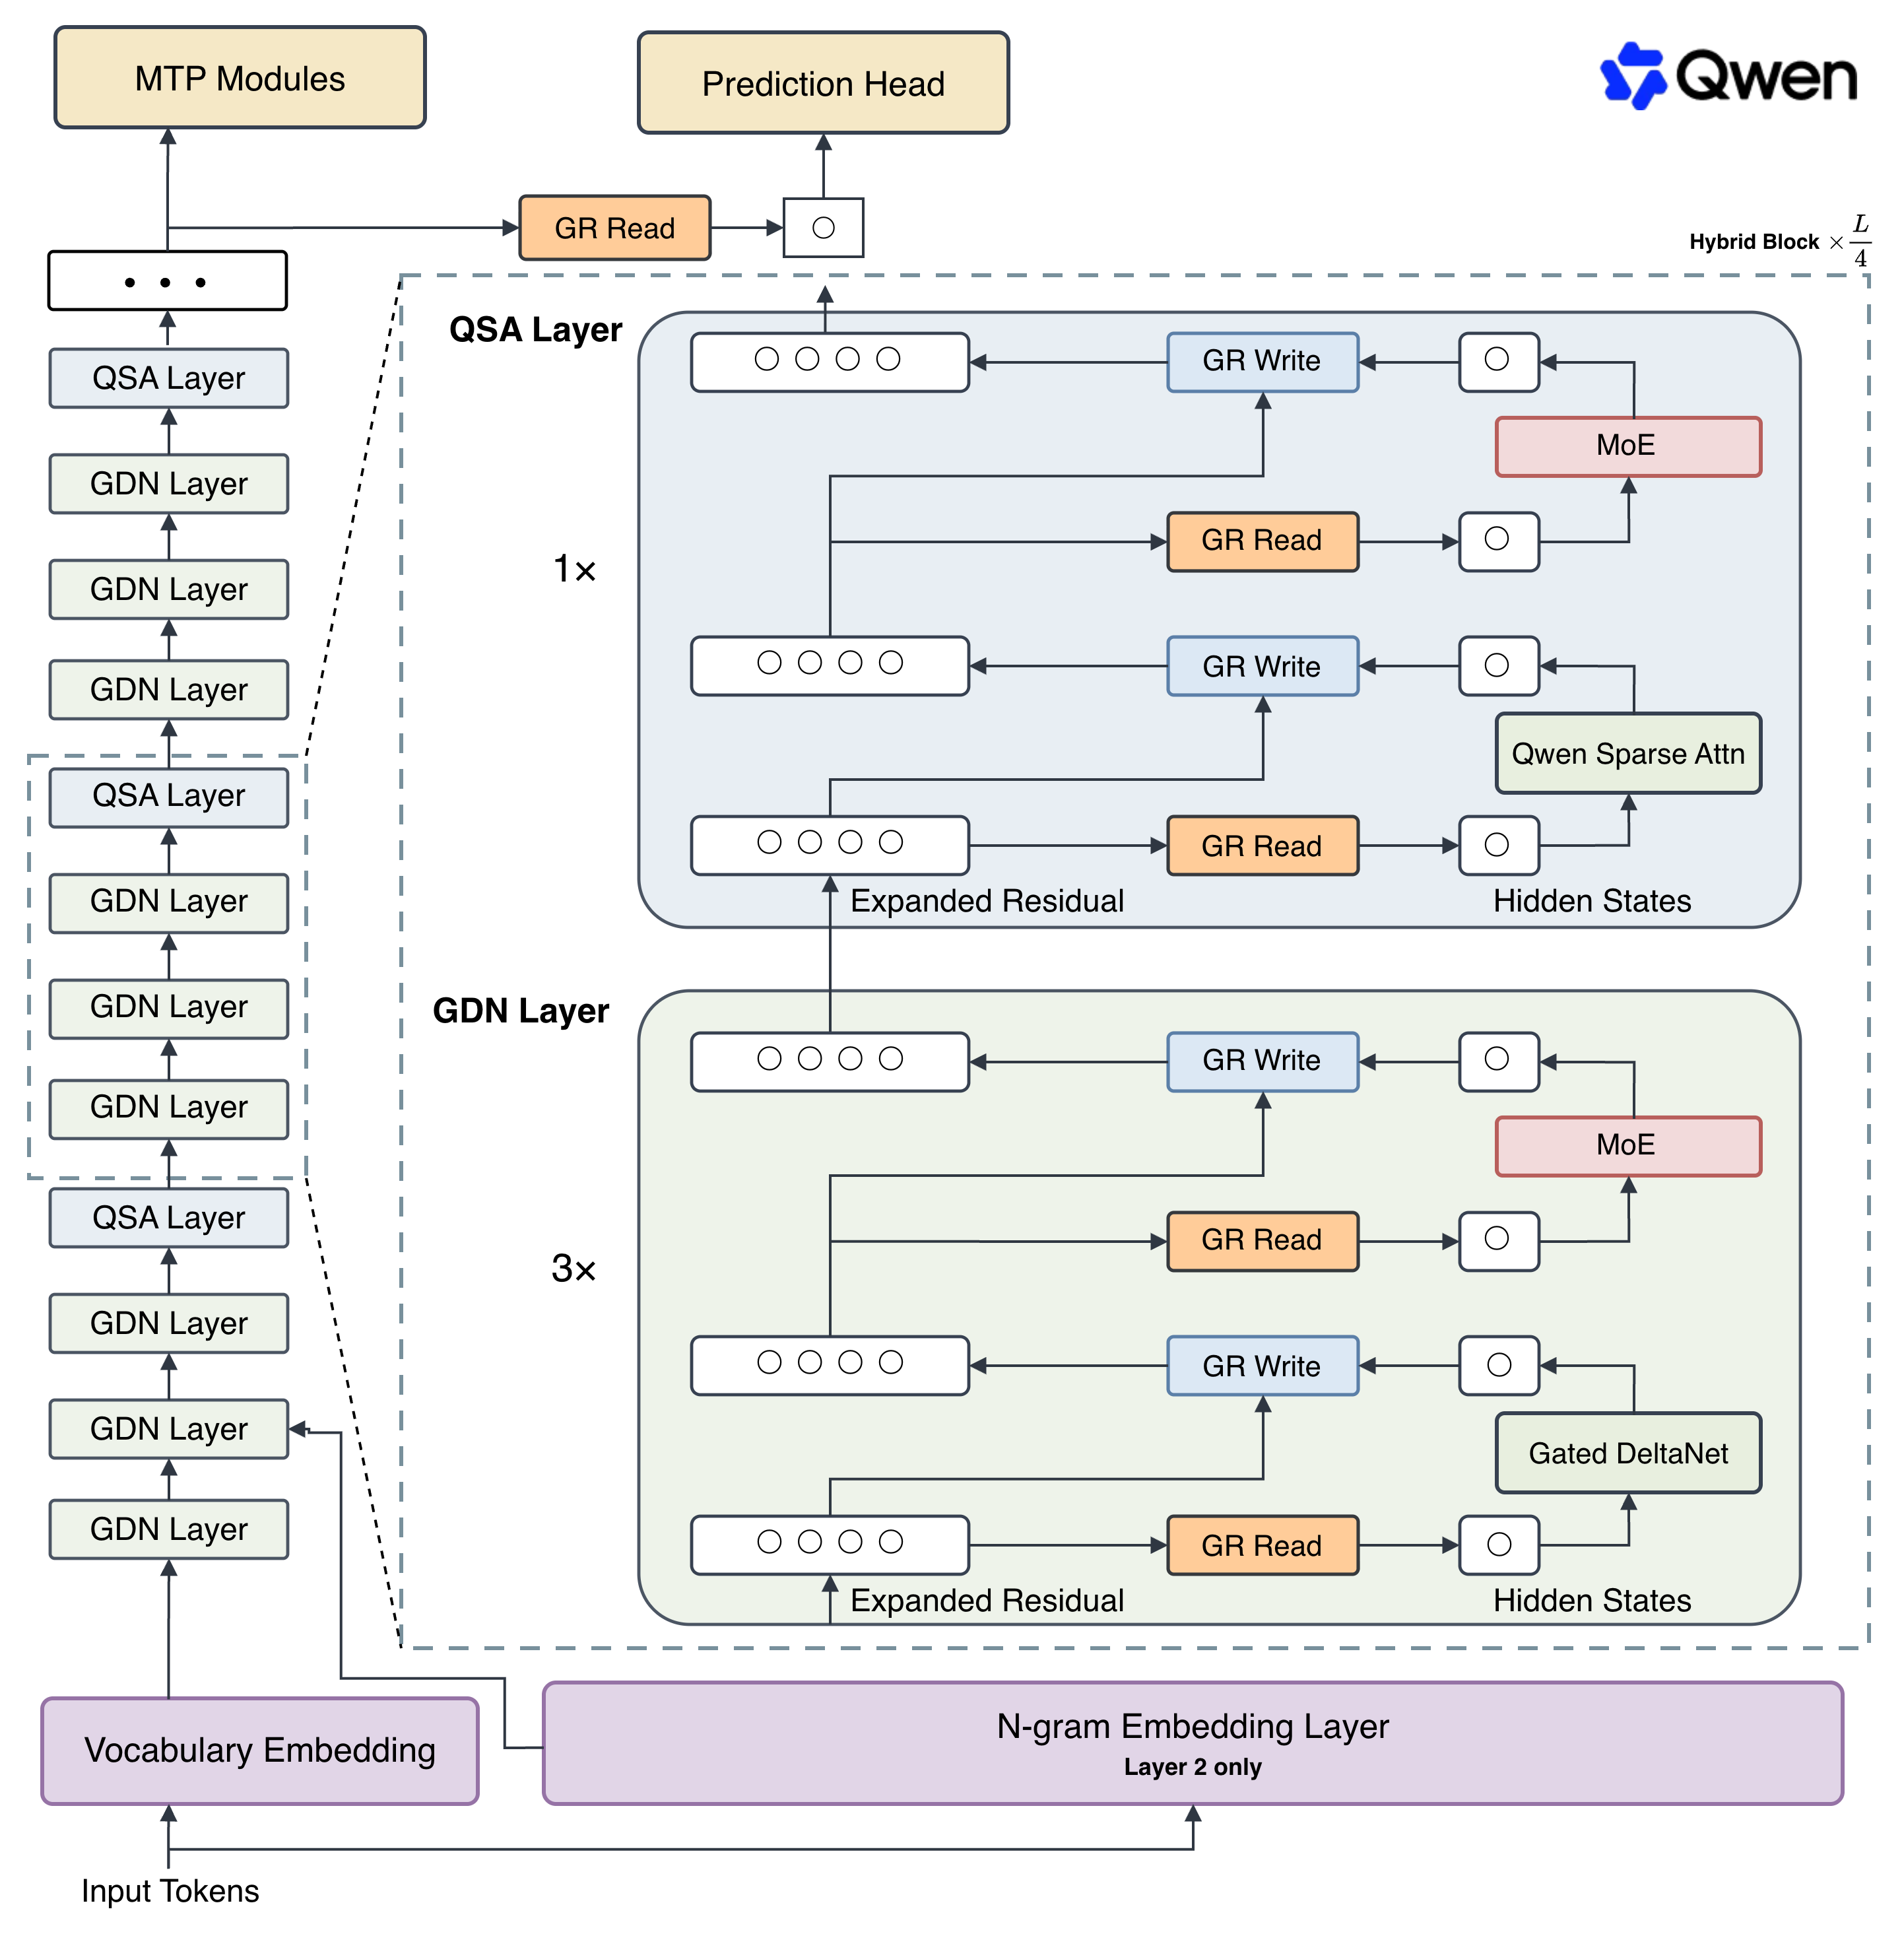
这一将支撑 Qwen4 的架构实验性预览,建立在对现代大语言模型(LLM)核心组件在大规模下如何交互的根本性重新思考之上。
亮点
该架构下的首个开源权重版本是 Qwen3.8-Flash-Next,它引入了:
- 基于 QSA 的混合注意力:Gated DeltaNet 与 Gated Attention 的组合被重构为 Gated DeltaNet 与 Qwen 稀疏注意力(QSA)。QSA 在微块级别操作,而非选择单个 token 进行处理。这显著降低了长上下文延迟,在 agent 工作负载日益主导实际应用的背景下是一项关键增益。
- Gated Residual:带归一化的残差流是深层 LLM 训练可控的关键。Gated Residual 通过逐元素、依赖数据的读门和逐分支的标量写门来调节流经加宽残差流的信息。这在各层之间带来更细粒度的表达能力,同时保持训练稳定性并将推理开销保持在较低水平。
- N-gram Embedding:Embedding 为参数扩展提供了独特的维度,相比 Mixture-of-Experts(MoE)需要更少的计算且更易于卸载。通过使用短 n-gram 进行索引,这种方法使参数扩展在内存受限的加速器上保持高效,同时不牺牲质量。
- 定制化训练方案:Muon 和 AdamW 优化器被应用于特定的权重类别以最大化效率。在重新拟合的 scaling law 指导下,我们取消了传统的 batch size 预热,直接以目标 batch size 开始训练,大幅减少优化器总步数,同时安全地支持更大的学习率以实现稳健收敛。
更多细节请参阅我们的博客文章 Qwen3.8-Flash-Next 和 技术报告。
我们很高兴与您一起开启这一新篇章,并欢迎您在构建未来的过程中提供反馈。
模型概览
- 类型:带视觉编码器的因果语言模型
- 训练阶段:预训练与后训练
- 语言模型
- 参数量:125B,激活 6B,另加 51B n-gram embedding 和 4B MTP
- 隐藏维度:2560
- Token Embedding:248320(已填充)
- N-gram Embedding:20,000,000(第 2 层的 bigram/trigram)
- 层数:48
- 隐藏布局:12 × (3 × (Gated DeltaNet → MoE) → 1 × (Qwen 稀疏注意力 → MoE))
- Gated DeltaNet:
- 线性注意力头数:V 为 48,QK 为 16
- 头维度:128
- Qwen 稀疏注意力:
- 注意力头数:Q 为 24,KV 为 2
- 头维度:256
- 旋转位置编码维度:64
- Indexer 结构:MQA,4 个 Query 头和 1 个共享 Key 头
- Indexer 头维度:128
- 预算:512 个块或 2048 个 token
- Mixture of Experts
- 专家数量:512
- 激活专家数量:10 个路由 + 1 个共享
- 专家中间维度:640
- Gated Residual:
- 分支数量:4
- 瓶颈秩:320
- LM 输出:248320(已填充)
- MTP:1 层,多步训练
- 上下文长度:原生 262,144,可扩展至 1,000,000 个 token。
Benchmark 结果
语言
视觉语言
快速开始
为简化集成,我们推荐通过 API 使用 Qwen3.8-Flash-Next。
部署 Qwen3.8-Flash-Next
[!Important] 不同框架的推理效率和吞吐量差异显著。 我们建议使用最新版本的框架以确保最佳性能和兼容性。 对于生产工作负载或高吞吐场景,强烈推荐使用专用 serving 引擎,如 SGLang、KTransformers 或 vLLM。
Qwen3.8-Flash-Next 可以使用流行的推理框架部署,例如:
- SGLang:Qwen3.8-Flash-Next Cookbook
- vLLM:Qwen3.8-Flash-Next Recipe
- TokenSpeed:Qwen3.8-Flash-Next Recipe
API 使用
[!Important] Qwen3.8-Flash-Next 模型默认以思考模式运行,在生成最终回复前会生成以
<think>\n...</think>\n\n标记的思考内容。 要禁用思考内容并获得直接回复,请参阅此处的示例。
[!Tip] 我们建议使用以下采样参数集进行生成:
- 思考模式:
temperature=1.0,top_p=0.95,top_k=20,min_p=0.0,presence_penalty=0.0,repetition_penalty=1.0- Instruct(或非思考)模式:
temperature=0.7,top_p=0.80,top_k=20,min_p=0.0,presence_penalty=1.5,repetition_penalty=1.0请注意,采样参数的支持因推理框架而异。
[!Tip] 在多轮 agentic 任务中,较低的推理强度并不总能减少整体任务完成时间。虽然它可能产生更快的单轮响应,但也可能导致分析不足、更多失败和重复重试,从而可能增加总延迟和 token 消耗。
Qwen3.8-Flash-Next 支持通过 enable_thinking、preserve_thinking 和 reasoning_effort 控制思考行为。
Chat Completions API
Chat Completions API 可用于大多数推理框架,以及 Qwen Cloud。 开始之前,请确保已安装并配置 API key 和 API base URL,例如:
pip install -U openai

# 根据实际情况设置以下内容
export OPENAI_BASE_URL="http://localhost:8000/v1"
export OPENAI_API_KEY="EMPTY"
纯文本输入
from openai import OpenAI
# 通过环境变量配置
client = OpenAI()

messages = [
    {"role": "user", "content": "编写一个 Python 函数来合并两个已排序的链表。"},
]

completion = client.chat.completions.create(
    model="Qwen/Qwen3.8-Flash-Next",
    messages=messages,
    extra_body={
        "chat_template_kwargs": {
            "enable_thinking": True,  # 默认开启
            "preserve_thinking": True, # 默认开启
        },
    },
    reasoning_effort="xhigh",  # 默认为 xhigh;支持级别为 xhigh、medium 和 low
    stream=True,
    stream_options={"include_usage": True},
)

reasoning_content = ""
answer_content = ""
is_answering = False
print("\n" + "=" * 20 + "推理过程" + "=" * 20 + "\n")

for chunk in completion:
    if not chunk.choices:
        print("\nUsage:")
        print(chunk.usage)
        continue

    delta = chunk.choices[0].delta

    if hasattr(delta, "reasoning_content") and delta.reasoning_content is not None:
        if not is_answering:
            print(delta.reasoning_content, end="", flush=True)
        reasoning_content += delta.reasoning_content
    elif hasattr(delta, "reasoning") and delta.reasoning is not None:
        if not is_answering:
            print(delta.reasoning, end="", flush=True)
        reasoning_content += delta.reasoning

    if hasattr(delta, "content") and delta.content:
        if not is_answering:
            print("\n" + "=" * 20 + "回答" + "=" * 20 + "\n")
            is_answering = True
        print(delta.content, end="", flush=True)
        answer_content += delta.content

messages.append({
    "role": "assistant",
    "content": answer_content,
    "reasoning_content": reasoning_content,
    "reasoning": reasoning_content,
})
图像输入
from openai import OpenAI
# 通过环境变量配置
client = OpenAI()

messages = [
    {
        "role": "user",
        "content": [
            {
                "type": "image_url",
                "image_url": {
                    "url": "https://qianwen-res.oss-accelerate.aliyuncs.com/Qwen3.5/demo/CI_Demo/mathv-1327.jpg"
                }
            },
            {
                "type": "text",
                "text": "图中四个圆的圆心位于正方形的四个角。两个大圆彼此相切,同时也与两个小圆相切。小圆的半径需要乘以哪个因子才能得到大圆的半径?\n选项:\n(A) $\\frac{2}{9}$\n(B) $\\sqrt{5}$\n(C) $0.8 \\cdot \\pi$\n(D) 2.5\n(E) $1+\\sqrt{2}$"
            }
        ]
    }
]

chat_response = client.chat.completions.create(
    model="Qwen/Qwen3.8-Flash-Next",
    messages=messages,
)
print("Chat response:", chat_response)
视频输入
from openai import OpenAI
# 通过环境变量配置
client = OpenAI()

messages = [
    {
        "role": "user",
        "content": [
            {
                "type": "video_url",
                "video_url": {
                    "url": "https://qianwen-res.oss-accelerate.aliyuncs.com/Qwen3.5/demo/video/N1cdUjctpG8.mp4"
                }
            },
            {
                "type": "text",
                "text": "墓室主室的壁龛中发现了多少个瓷罐?"
            }
        ]
    }
]

chat_response = client.chat.completions.create(
    model="Qwen/Qwen3.8-Flash-Next",
    messages=messages,
)

# 当 vLLM 以 `--media-io-kwargs '{"video": {"num_frames": -1}}'` 启动时,
# 可以通过 `extra_body` 配置视频帧采样(例如,通过设置 `fps`)。
# 此功能目前仅在 vLLM 中支持。
#
# 默认情况下,`fps=2` 且 `do_sample_frames=True`。
# 当 `do_sample_frames=True` 时,您可以自定义 `fps` 值来设置所需的视频采样率。
# chat_response = client.chat.completions.create(
#     model="Qwen/Qwen3.8-Flash-Next",
#     messages=messages,
#     extra_body={
#         "mm_processor_kwargs": {"fps": 2, "do_sample_frames": True},
#     },
# )

print("Chat response:", chat_response)
Instruct(或非思考)模式
Qwen3.8-Flash-Next 默认在响应前进行思考。 您可以通过配置 API 参数获得模型的直接响应,无需思考。 例如,
from openai import OpenAI
# 通过环境变量配置
client = OpenAI()

messages = [
    {
        "role": "user",
        "content": [
            {
                "type": "image_url",
                "image_url": {
                    "url": "https://qianwen-res.oss-accelerate.aliyuncs.com/Qwen3.5/demo/RealWorld/RealWorld-04.png"
                }
            },
            {
                "type": "text",
                "text": "这是哪里?"
            }
        ]
    }
]

chat_response = client.chat.completions.create(
    model="Qwen/Qwen3.8-Flash-Next",
    messages=messages,
    temperature=0.7,
    top_p=0.8,
    presence_penalty=1.5,
    extra_body={
        "top_k": 20,
        "chat_template_kwargs": {"enable_thinking": False},
    },
)
print("Chat response:", chat_response)
[!Note] 如果您使用 Qwen Cloud 的 API,除了更改
model外,请直接使用"enable_thinking": False,而不是"chat_template_kwargs": {"enable_thinking": False}。
禁用保留思考
默认情况下,Qwen3.8-Flash-Next 会保留所有历史消息中的思考块,在对话中维持完整的推理轨迹。这种行为称为保留思考,可确保完整的上下文连续性,对于决策一致性和减少冗余推理至关重要的 agent 场景尤其有益。它还能改善 KV cache 利用率,在思考和非思考模式下均优化推理效率。
如果您希望仅保留最新用户消息中的思考块,可以通过将 preserve_thinking 设置为 False 来禁用此行为:
from openai import OpenAI

# 通过环境变量配置
client = OpenAI()
messages = [...]
chat_response = client.chat.completions.create(
    model="Qwen/Qwen3.8-Flash-Next",
    messages=messages,
    extra_body={
        "chat_template_kwargs": {"preserve_thinking": False},
    },
)
print("Chat response:", chat_response)
[!Note] 如果您使用 Qwen Cloud 的 API,除了更改
model外,请直接使用"preserve_thinking": False,而不是将其包装在chat_template_kwargs中。
最佳实践
为获得最佳性能,我们建议以下设置:
采样参数:我们建议使用以下采样参数集:
- 思考模式:
temperature=1.0,top_p=0.95,top_k=20,min_p=0.0,presence_penalty=0.0,repetition_penalty=1.0 - Instruct(或非思考)模式:
temperature=0.7,top_p=0.80,top_k=20,min_p=0.0,presence_penalty=1.5,repetition_penalty=1.0
对于支持的框架,您可以将
presence_penalty参数调整为 0 到 2 之间的值以减少无休止的重复。然而,使用较高的值偶尔可能导致语言混合和模型性能轻微下降。- 思考模式:
充足的输出长度:为优化 agentic 任务的性能,我们建议分配足够的输出长度,使模型能够生成详细且全面的响应。对于支持内部推理和最终输出分别设置 token 限制的框架,我们建议在 1M 上下文长度内进行以下配置:
- 推理内容:将最大输出长度设置为 262,144 个 token。
- 最终响应:将最大输出长度设置为 131,072 个 token。
这些设置为复杂推理提供了必要的能力,同时确保为高质量的最终交付物留出充足空间。
处理超长文本:Qwen3.8-Flash-Next 原生支持最长 262,144 个 token 的上下文长度。对于总长度(包括输入和输出)超过此限制的长时程任务,我们建议使用 RoPE 缩放技术来有效处理长文本,例如 YaRN。
YaRN 目前受多个推理框架支持,例如 vLLM、SGLang 和 TokenSpeed。 通常,对于支持的框架启用 YaRN 有两种方法:
修改模型配置文件:
在
config.json文件中,将text_config中的rope_parameters字段修改为:{ "mrope_interleaved": true, "mrope_section": [ 11, 11, 10 ], "rope_type": "yarn", "rope_theta": 10000000, "partial_rotary_factor": 0.25, "factor": 4.0, "original_max_position_embeddings": 262144 }传递命令行参数:
对于 vLLM,您可以使用
VLLM_ALLOW_LONG_MAX_MODEL_LEN=1 vllm serve ... --hf-overrides '{"text_config": {"rope_parameters": {"mrope_interleaved": true, "mrope_section": [11, 11, 10], "rope_type": "yarn", "rope_theta": 10000000, "partial_rotary_factor": 0.25, "factor": 4.0, "original_max_position_embeddings": 262144}}}' --max-model-len 1000000对于 SGLang,您可以使用
SGLANG_ALLOW_OVERWRITE_LONGER_CONTEXT_LEN=1 python -m sglang.launch_server ... --json-model-override-args '{"text_config": {"rope_parameters": {"mrope_interleaved": true, "mrope_section": [11, 11, 10], "rope_type": "yarn", "rope_theta": 10000000, "partial_rotary_factor": 0.25, "factor": 4.0, "original_max_position_embeddings": 262144}}}' --context-length 1000000对于 TokenSpeed,您可以使用
TOKENSPEED_ALLOW_OVERWRITE_LONGER_CONTEXT_LEN=1 tokenspeed serve ... --hf-overrides '{"text_config": {"rope_parameters": {"mrope_interleaved": true, "mrope_section": [11, 11, 10], "rope_type": "yarn", "rope_theta": 10000000, "partial_rotary_factor": 0.25, "factor": 4.0, "original_max_position_embeddings": 262144}}}' --max-model-len 1000000
[!NOTE] 所有知名的开源框架都实现了静态 YaRN,这意味着缩放因子不随输入长度变化,可能影响较短文本上的性能。 我们建议仅在需要处理长上下文时才修改
rope_parameters配置。 还建议根据需要修改factor。例如,如果您的应用典型上下文长度为 524,288 个 token,最好将factor设置为 2.0。长视频理解:为优化纯文本和图像的推理效率,发布的
video_preprocessor_config.json中的size参数配置较为保守。建议将 video_preprocessor_config 文件中的longest_edge参数设置为 469,762,048(对应 224k 视频 token),以便为小时级视频启用更高帧率采样,从而获得更优性能。例如,{"longest_edge": 469762048, "shortest_edge": 4096}
引用
如果您觉得我们的工作有帮助,欢迎引用我们。
@techreport{qwen2026design,
    title       = {On the Design of {Qwen3.8-Next} Architecture: Evaluation, Efficiency, and Training Stability},
    author      = {{Qwen Team}},
    institution = {Alibaba Group},
    month       = {August},
    year        = {2026}
}

@misc{qwen3.8flashnext,
    title  = {{Qwen3.8-Flash-Next}: A New Architecture, Towards Ultimate Cost-Efficiency},
    author = {{Qwen Team}},
    month  = {August},
    year   = {2026},
    url    = {https://qwen.ai/blog?id=qwen3.8-flash-next}
}